
解説
uniqだけでは重複が残る?sortと組み合わせて行ごとの件数を数えよう
uniqがまとめるのは隣り合う同じ行。離れた同じ行と、大文字・小文字の条件を、架空のテキストを使ってGNUのコマンドで確認する。
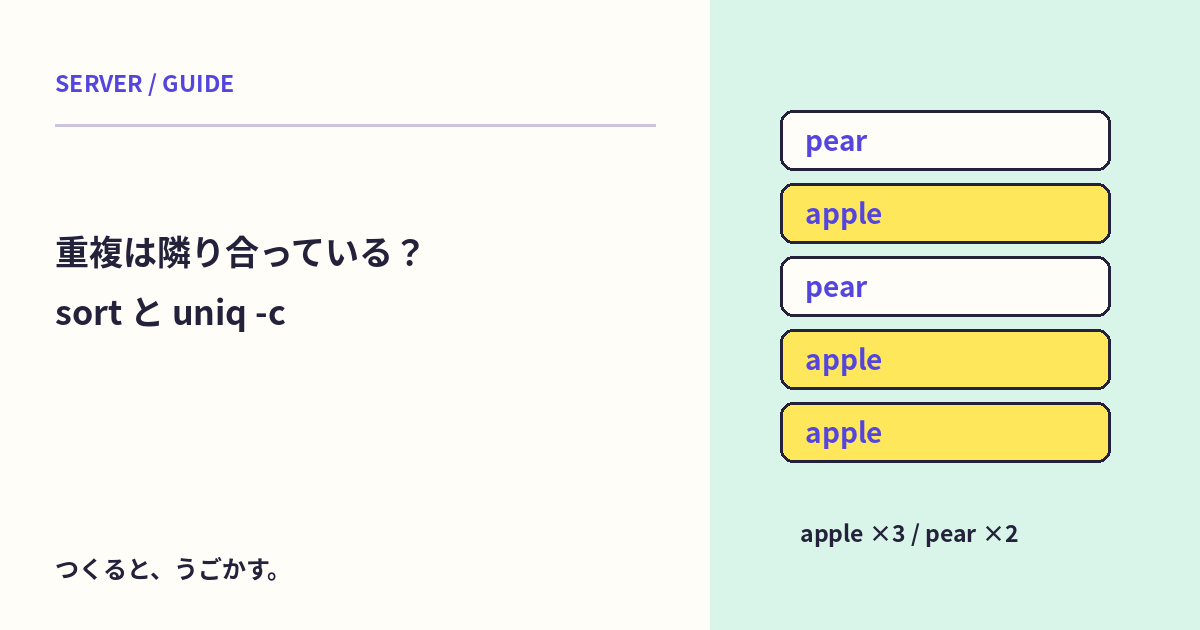
同じ名前の行を一つにしたいのに、uniqを実行しても重複が残る。uniqがまとめるのは、隣り合う同じ行だからだよ。離れた場所にも同じ行があるなら、先に並べる方法を検討しよう。
今回はGNU coreutils 9.7とBashで確認した例。新しい空の練習フォルダーを使い、実際の顧客名などは入れない。macOSなど別の実装では、手元のヘルプも確認してね。
五つの行を用意する
printf 'pear\napple\npear\napple\napple\n' > items.txt
uniq -c items.txt
最後のapple二行は隣り合っているので2件にまとまる。一方、最初と三番目のpearは、その間にappleがあるので別のままになる。表示は順にpearが1、appleが1、pearが1、appleが2だよ。
-cは、まとめた行の件数を付ける指定。全体の中に同じ値が何回あったかを、順序と無関係に数えてくれる指定ではないんだ。
並べてから数える
LC_ALL=C sort items.txt | uniq -c
sortで同じ行を隣へ集め、|でその出力をuniqへ渡す。期待する結果はappleが3、pearが2。LC_ALL=Cは、今回のASCIIの単語の並べ方を一定の条件にするための指定だよ。
元ファイルを上書きするコマンドではない。画面への表示結果が変わるだけなので、items.txtを開いて元の順序が残っていることも確かめよう。
件数が不要で、異なる行を一つずつ表示したい場合は、今回の条件ならLC_ALL=C sort -u items.txtも選べる。ただし元の登場順を残す処理ではないよ。
何を同じと判断するかを先に決める
今回の単語は小文字だけで、余分な空白も付けていない。appleとApple、末尾にスペースのある行などを同じ扱いにするかは、別の条件になる。
大文字・小文字を無視するなら、それに合う並べ方と重複判定をそろえる必要がある。数字順などのsortの条件も、単に追加すればどんな重複判定にも合うわけではない。まず完全に同じ行という小さな条件で確認しよう。
また、引用符内に改行を含むCSVは、一行が一レコードとは限らない。ファイル形式の構造を理解せず、CSVのレコード件数として使わないようにしよう。
確認した結果と片付け
編集部では、一時フォルダーで隣接した重複だけがまとまること、sort後の3件・2件、sort -uの二つの単語、元ファイルの保持を確認した。全角文字や言語ごとの照合まで確認した結果ではないよ。
練習用ファイルが不要になったら、作業場所を確認してから片付けよう。入力と出力の渡し方はパイプとリダイレクトの違い、レコードの単位はCSVの引用符と行数も参考になる。
みんなのコメント 0
感想や、試してみたことを聞かせてね。コメント・返信は承認後に公開されます。
最初のコメントをどうぞ。