
解説
AIが作った正規表現は全文を調べている?searchとfullmatchで検証しよう
半角数字3桁だけを認めたいのに、前後に文字があっても一致する。Pythonのsearchとfullmatch、全角数字と改行の境界を確認する。
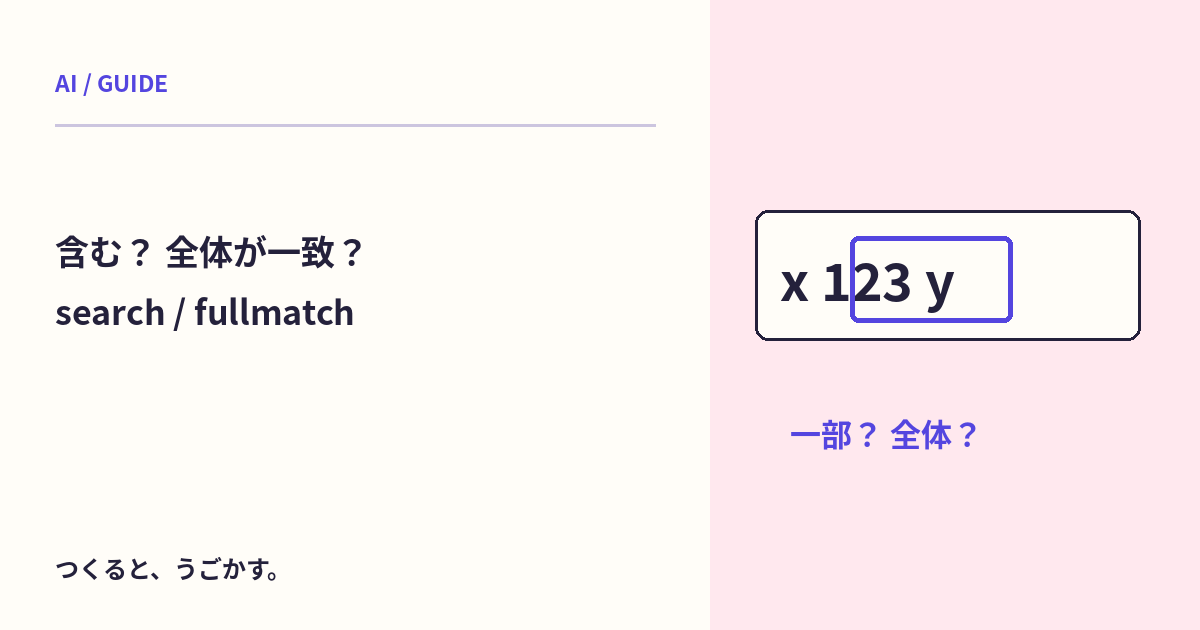
AIが作った正規表現で入力を確認したら、x123yまで通ってしまった。「半角数字3桁を含む」ことと、「文字列全体が半角数字3桁だけである」ことを混同していないか見直そう。
今回はPython 3.12のreを使う。正規表現は、文字の並びの条件を書く仕組み。任意の利用者データではなく、短い架空の文字列で動作を確かめるよ。
同じパターンでも、探す方法で結果が違う
import re

value = "x123y"
pattern = r"[0-9]{3}"
print(bool(re.search(pattern, value)))    # True
print(bool(re.fullmatch(pattern, value))) # False
searchは、文字列の中に一致する部分があるか探す。x123yには123という部分があるので一致する。fullmatchは文字列全体の一致を要求するため、前後のxとyがあると一致しない。
パターンの文字だけを見て確認するのではなく、どの関数へ渡すかまでを一組で読む必要があるよ。
「数字」をどこまで含めるかも決める
今回の[0-9]は、半角の0から9。{3}は、直前の条件がちょうど3回続くという指定。全角の123は、この条件では対象にしていない。
Pythonの通常のUnicode文字列では、\dが全角数字などにも一致する場合がある。「半角だけ」の仕様なら、\dへ機械的に置き換えないようにしよう。
これは全角数字が常に悪い入力という意味ではない。認める文字を決め、必要なら変換する条件も別に設計するという話だよ。
成功例だけでなく、前後の文字も試す
import re

samples = ["123", "x123y", "123", "", "123\n"]
for value in samples:
    partial = bool(re.search(r"[0-9]{3}", value))
    whole = bool(re.fullmatch(r"[0-9]{3}", value))
    print(repr(value), partial, whole)
期待する全体一致は123だけ。x123yと末尾に改行のある123は、部分検索では一致しても全体一致はしない。空文字列や全角数字も、今回の全体一致ではFalseになる。
文字列の先頭・末尾を示す記号にも、改行やオプションに関係する規則がある。入力全体の確認をしたいなら、まずその目的に合うfullmatchを選び、境界の例を実行して確かめよう。
AIへの依頼に、関数とテスト例を入れる
Python 3.12の通常の文字列を対象にします。
文字列全体が半角数字3桁だけの場合にTrueにしたいです。
部分一致は認めません。re.fullmatchを使った例を示してください。
123、x123y、全角の123、空文字列、末尾改行ありの結果も示してください。
編集部が作成した依頼文の例だよ。モデルへ実行させたと主張するものではなく、返ってきたコードを手元で検証するために条件をそろえるもの。
正規表現の動作は言語やオプションでも変わる。Pythonで確かめたパターンを、JavaScriptやGoogleドキュメントの検索へそのまま移して同じ動作だと決めつけないようにしよう。
編集部ではPython 3.12で五つの文字列の部分一致・全体一致と、\dの全角数字への一致を確認した。長い複雑なパターンの性能や、あらゆる不正入力への耐性まで検証したものではないよ。
仕様の境界を決める考え方はAIの境界テスト、文字列の変換はUnicodeの正規化と識別も参考にしてね。
みんなのコメント 0
感想や、試してみたことを聞かせてね。コメント・返信は承認後に公開されます。
最初のコメントをどうぞ。