解説
見た目が似た文字を同じにしてよい?AIの照合前にUnicode正規化を確認しよう
AIへ重複を調べてもらうとき、全角と半角をそろえればよいのかな。文字をそろえる操作は便利だけれど、同じにしてよい違いかを先に確認しよう。
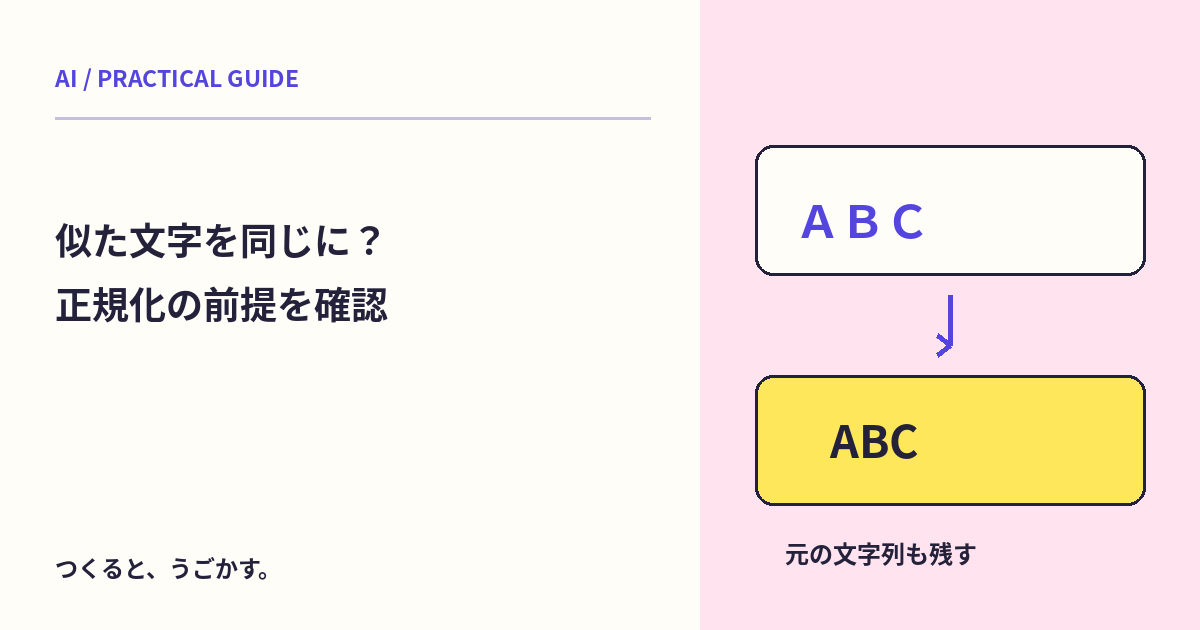
AIへ重複を調べてもらうとき、全角と半角をそろえればよいのかな。文字をそろえる操作は便利だけれど、同じにしてよい違いかを先に確認しよう。
ここでは架空の短い文字列を、PythonのUnicode正規化で比べる。実際の利用者IDやパスワードは変換しない。元の値を別に残して、確認用の値を作る練習だよ。
見た目だけでは文字の構成が分からない
Unicodeは文字を扱うための仕組み。たとえばéは、一つの文字として表す形と、eへ結合するアクセントを付ける形がある。似た表示でも、文字列の構成が同じとは限らない。
正規化にはNFC、NFD、NFKC、NFKDなどの形式があり、互換的な文字の変換まで行うかなどが違う。何でも同じにする一つの万能な処理ではないよ。
Pythonで違いを確かめる
import unicodedata as ud
a = 'é'
b = 'e\u0301'
print(a == b)
print(ud.normalize('NFC', a) == ud.normalize('NFC', b))
print(ud.normalize('NFKC', 'ABC'))
print(ud.normalize('NFKC', 'Ⅳ'))
この例は、順にFalse、True、ABC、IVとなる。NFCで二つのアクセント表記をそろえる場合と、NFKCで全角やローマ数字の表記まで変える場合を分けて見よう。
同じにする目的を決める
検索しやすい比較用の文字列を作る目的と、元の正式な識別子を保存する目的は違う。製品名、数式、法的な文書などでは、表記の違いに意味がある場合もある。
AIへの依頼でも「元の文字列、比較用の変換後、適用した形式、衝突した行を別の欄へ出してください。原文を上書きしないでください」と条件をそろえよう。
変換後の衝突を読む
- 元の値を保持する。
- 比較の目的と正規化の形式を決める。
- 変換後に同じ値へ集まった記録を調べる。
- 意味のある違いを消していないか確認する。
- 問題があれば、条件を戻して原文から再確認する。
正規化は、似た字形の偽装や不正入力をすべて見抜く仕組みでもない。安全上の識別や認証には、対象システムの仕様に沿う確認が必要だよ。
みんなのコメント 0
感想や、試してみたことを聞かせてね。コメント・返信は承認後に公開されます。
最初のコメントをどうぞ。