解説
robots.txtで止めると検索から消える?クロール制限とnoindexを分けよう
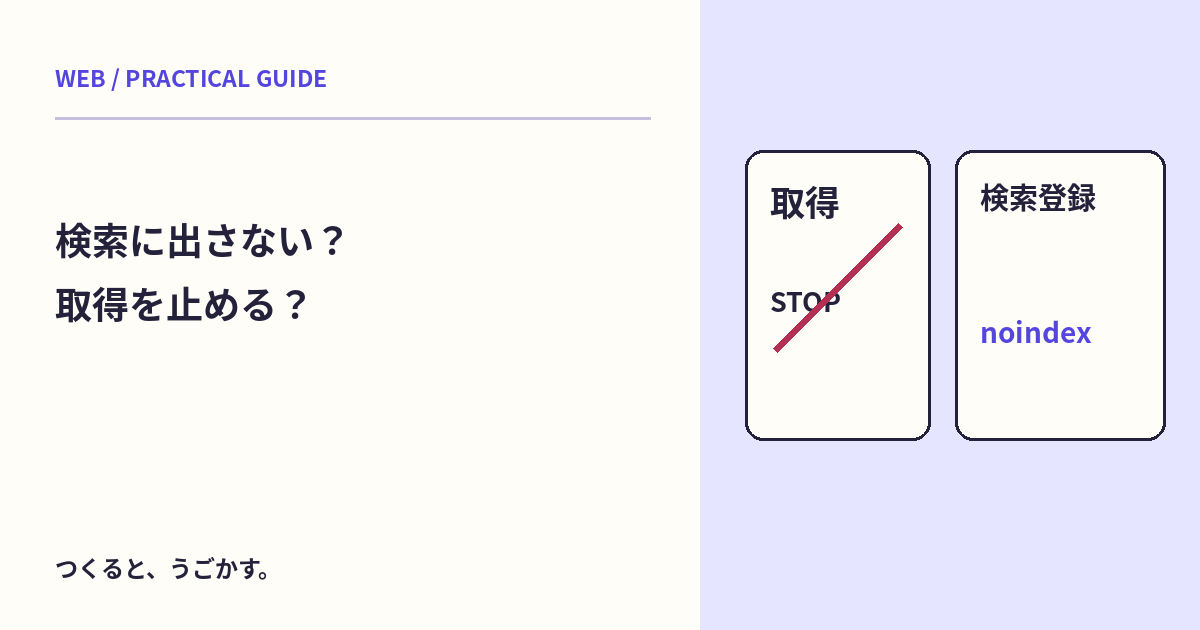
検索結果に出したくないページを、robots.txtでブロックすればよいと思っていないかな。取得を制限することと、検索結果への登録を止めることは別の話だよ。
検索結果に出したくないページを、robots.txtでブロックすればよいと思っていないかな。取得を制限することと、検索結果への登録を止めることは別の話だよ。
この記事ではGoogle検索を対象に、クロールとインデックスを区別する。必要なのは確認用のURL一覧。サイト全体の設定を書き換える前に、ページごとの目的を整理しよう。
読みに来ることと、検索へ登録すること
クロールは、検索エンジンがURLを取得して内容を確認すること。インデックスは、検索に使う情報として登録すること。この二つは関係するけれど同じ操作ではないよ。
robots.txtのDisallowは、対応するクローラーによる取得の制御に使う。一方noindexは、そのページを検索結果へ登録しないよう伝える指定。Googleがnoindexを認識するには、ページへアクセスしてその指定を読める必要がある。
同時に止めると、指定を読めない場合がある
Googleの公式説明では、robots.txtで取得をブロックしたURLについて、noindexを読めず、外部リンクなどの情報からURLだけが検索結果に現れる場合がある。
「非公開だからrobots.txtへ書く」はアクセス制限の代わりにはならないよ。robots.txt自体は公開され、すべての訪問者を止める認証機能でもない。個人情報や管理画面には、ログインなど実際のアクセス制御が必要。
| 目的 | 主に確認する仕組み |
|---|---|
| 秘密の情報を守る | 認証・認可、公開保存先の見直し |
| 公開だがGoogle検索には出さない | 読み取れるnoindex |
| クローラーによる取得を制御する | robots.txtと各クローラーの仕様 |
公開前の確認手順
- 対象URLが、一般公開・検索除外・認証必須のどれかを決める。
- 検索除外なら、実際のHTMLまたはHTTPヘッダーのnoindexを確認する。
- Googleがその指定を読めるか、robots.txtも合わせて見る。
- Search ConsoleのURL検査で取得・登録の状態を確認する。
反映は即時とは限らない。すでに機密情報を公開してしまった場合は、再クロールを待つだけでなく、まず公開元へのアクセスを止めよう。
みんなのコメント 0
感想や、試してみたことを聞かせてね。コメント・返信は承認後に公開されます。
最初のコメントをどうぞ。