解説
画像の文字をAIで読むときは?数字・行・読めない部分を照合しよう
画像内の文字を取り出す依頼の基本。向きや文字の小ささを整え、読み取りと推測を分けるプロンプトと、元画像へ戻る確認方法を紹介するよ。
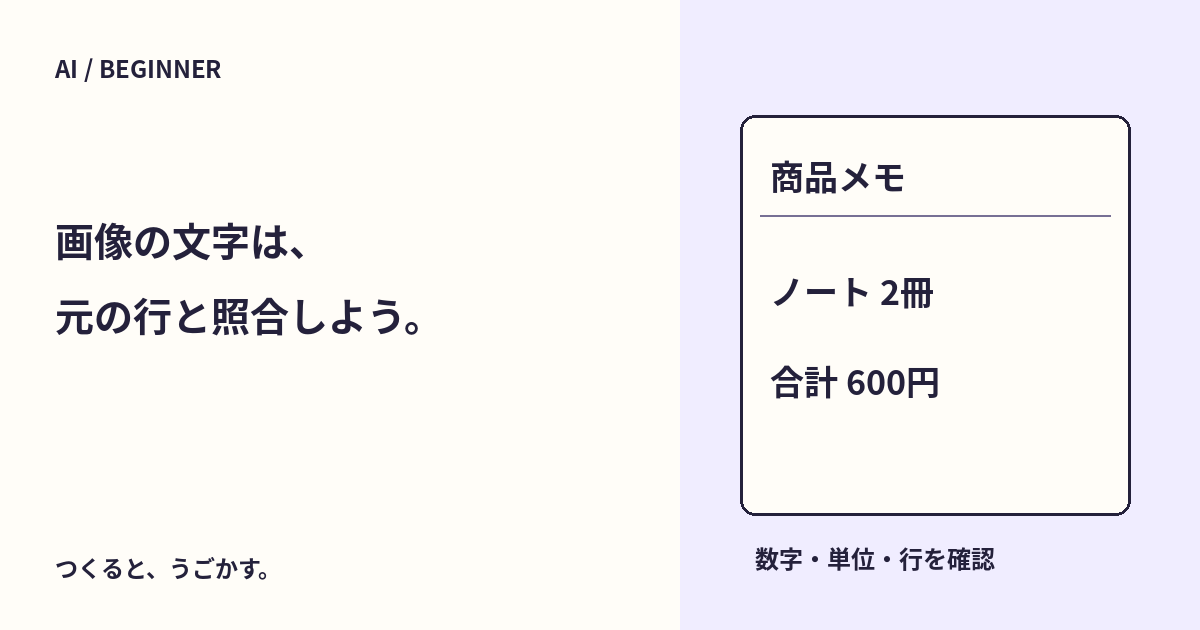
画像に写った商品メモを、文字として整理したい。画像入力に対応したAIは手助けになることがあるけれど、見えない文字を正確に補えるわけではないよ。今回は、画像の文字を読む依頼と、結果を確かめる順番を整理しよう。
目標は、読み取り結果をそのまま信じず、元の画像へ戻って確認できること。実際に試す場合は画像入力に対応したサービスが必要で、利用条件や費用はそのサービスで確認する。ここでは個人情報のない、編集部が描いた架空のメモを使うよ。
文字を読むことと、内容を推測することを分ける
画像内の文字を文字データへ取り出す処理は、OCRと呼ばれることがある。画像を扱える生成AIも文字を読む用途に使われるけれど、入力できる形式や得意な内容はサービス・モデルによって異なる。
OpenAIの画像入力の資料でも、小さな文字、回転した画像、日本語など非ラテン文字を含む文章、読み取りの正確さなどに制約が説明されている。「画像を受け付けた」だけで、細かい数字まで正しいとは判断しないでね。
まず、見える状態を整える
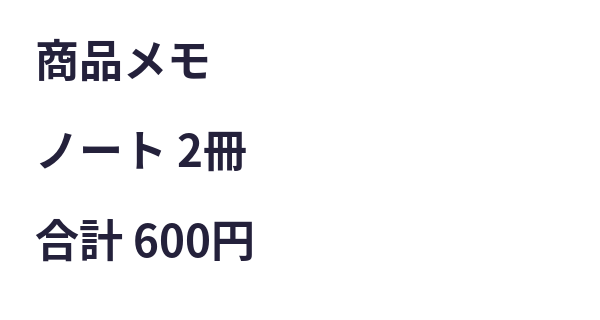
架空の商品メモには「商品メモ」「ノート 2冊」「合計 600円」の三行を描いている。この文字は、元データとして編集部が指定した内容で、AIが読み取った結果ではないよ。
実際の画像では、次を確認しよう。
- 文字が上下逆や横向きになっていないかを見る。
- 余計な背景を減らしつつ、行の端や必要な数字を切り落とさないようにする。
- 文字がつぶれない元画像を選ぶ。小さい画像を単に拡大しても、失った細部が戻るとは限らない。
- 氏名、住所、顧客情報などを、そのサービスへ入力してよいか確認する。
切り取り範囲に迷ったら、リサイズとトリミングの作例も参考になるよ。
読めない箇所を残すように頼む
たとえば、次のように依頼できる。
画像の文字を、行の順番を保って書き出してください。
読めない部分は【不明】とし、前後の内容から補わないでください。
数字・単位・記号も元の表記のままにしてください。
要約や計算は、今回はしないでください。
この指示は、読み取りと要約を混ぜにくくするための例。特定モデルを実行した結果や、誤りを完全に防ぐ仕組みではない。まだ読めていない項目を、自然な文章で埋めないようにする意図だよ。
結果は行ごとに、元の画像と比べる
練習用メモなら、三行の順序、「2」と「600」、単位の「冊」と「円」を照合する。合計の数字を見て「1冊300円」と推測できても、画像に単価が書かれていることにはならない。
実際の資料では、0とO、1とI、小数点、マイナス、日付、通貨記号なども要注意。数字が変わると結果に影響する箇所は、画像を拡大して自分で確認しよう。
読めない場合は、画像を取り直す選択肢もある
文字が反射で隠れたり、行の端が欠けたりしているなら、別の画像を用意するほうがよい場合がある。同じ画像へ何度も依頼して、たまたまもっともらしい答えが出たものを採用しないでね。
読み取れた文字を要約するときも、読み取りの確認を終えてから別の工程へ進もう。入力してよい情報の選び方は、AIへ渡す情報を絞る記事でも整理しているよ。
みんなのコメント 0
感想や、試してみたことを聞かせてね。コメント・返信は承認後に公開されます。
最初のコメントをどうぞ。